この記事の目次を開く
読みを直す最初の一手は、問題の語をかなにする
ElevenLabsで日本語の固有名詞や日付を意図した読み方にしたいときは、まず声・モデル・設定を固定して、その語だけ読みを明示する方法を試します。『日本橋』のように場所によって読みが違う語や、『一日』のように意味で読みが変わる語は、音声の雰囲気を調整する前に確認したい箇所です。
ただし、漢字をかなに変えれば必ず良くなるわけではありません。正しい読みがすでに出ている場合もあり、かなが長く続くと語の区切りやアクセントが変わることもあります。最初から全文をかなにせず、必要な範囲を短い文で比較すると、修正の効果を確かめやすくなります。
この記事では2026年10月13日、ログイン済みのText to Speechで自作の架空案内文を実際に生成しました。漢字中心の原稿と読みを明示した原稿について、同じYui・Eleven v4で生成した画面を掲載しています。音声の生成と保存は確認済みですが、読みの正誤と修正成功は聴取評価が未確認です。画面に文字が入ったことだけを、発音が直った証拠にはしていません。
先に『正解の読み』を原稿の用途から決める
読みの修正は、AIがどう読むかを調べる前に、制作側が何と読ませたいかを決める作業から始まります。人名なら本人の読み、店名なら公式表記、地名なら対象地域の読みを確認してください。一般的な辞書の読みと、その固有名詞の読みが同じとは限りません。
表は左右にスクロールできます。
| 今回の語 | この台本で意図する読み | 確認する理由 |
|---|---|---|
| 東京の日本橋 | にほんばし | 対象を東京として指定する |
| 一日だけ | いちにちだけ | 日付ではなく期間を表す |
| 生物の展示 | せいぶつの展示 | 生き物の展示という設定 |
| 四月一日 | しがつついたち | 月日として読む |
| 午前九時 | 午前くじ | 時刻として読む |
| 一人三百円 | ひとりさんびゃくえん | 人数と金額を区切る |
この表はテストの目標であり、変更前の音声がすべて誤読したという結果表ではありません。公開する本番原稿では、地名・人名の確認先も記録しておくと、後から『どちらの読みが正しいのか』で迷いにくくなります。
実画面:まず漢字の原稿を、そのまま一度生成する
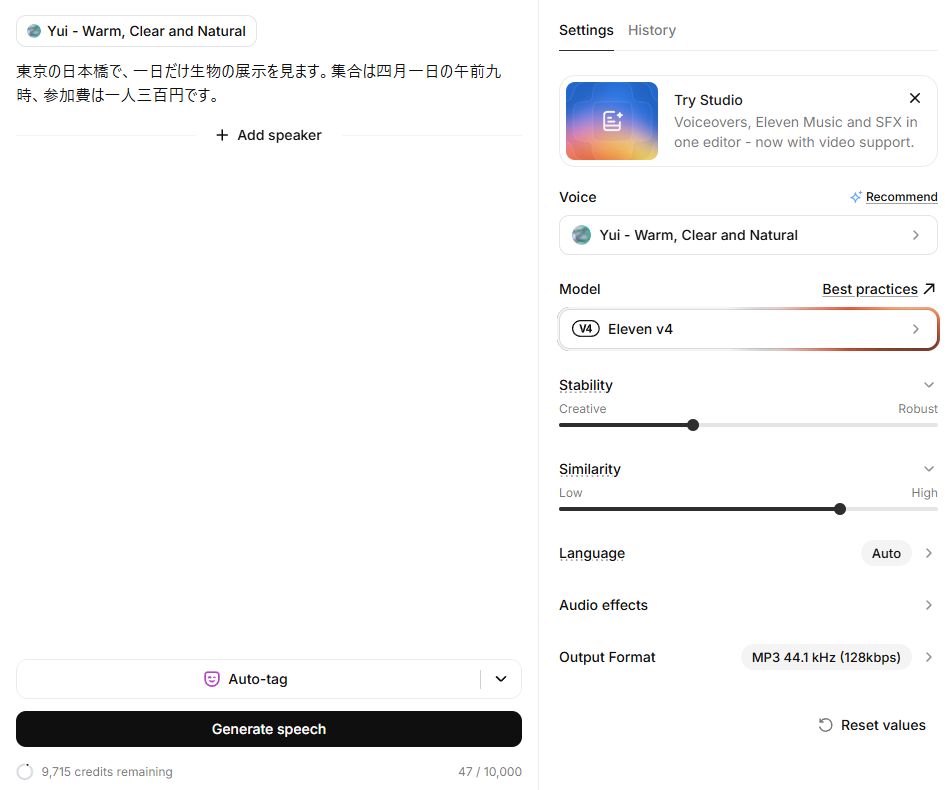
Text to Speechへ、次の47文字の原稿を入力しました。実在するイベントの告知ではなく、読み方を比較するための架空の案内です。
東京の日本橋で、一日だけ生物の展示を見ます。集合は四月一日の午前九時、参加費は一人三百円です。
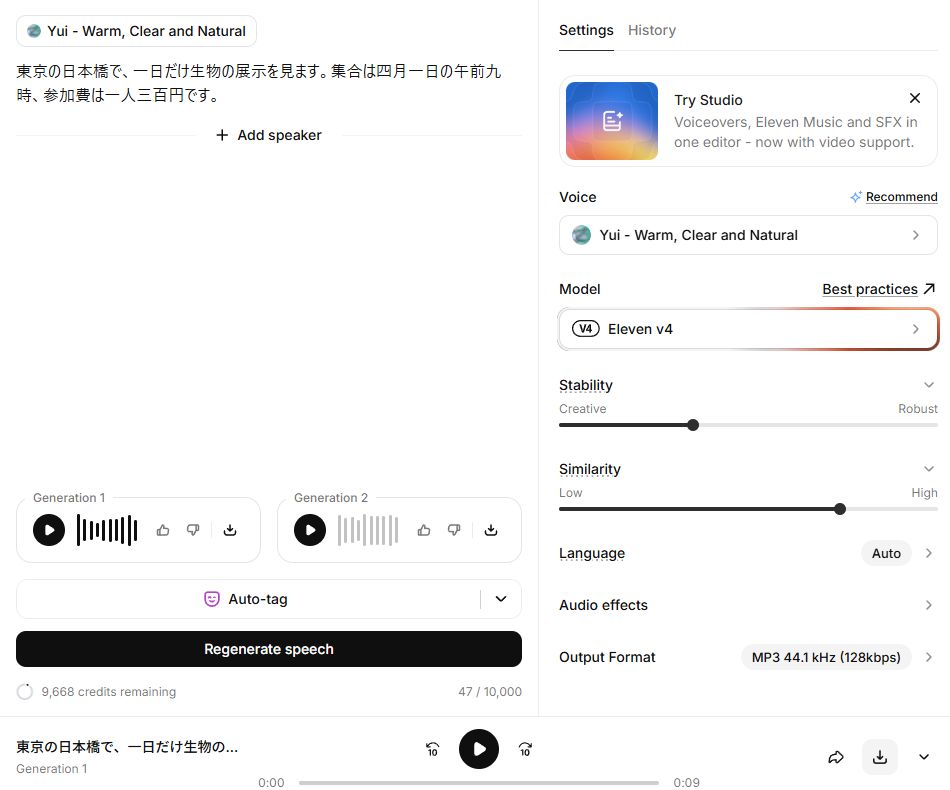
条件は、声がYui - Warm, Clear and Natural、モデルがEleven v4、Stability 35%、Similarity 75%、Language Auto、出力はMP3 44.1 kHz(128kbps)です。モデルや設定を変更せず、生成ボタンを一度押しました。画面はGeneration 1とGeneration 2の候補を表示しましたが、本記事の比較対象はGeneration 1です。
実画面:声を固定し、読ませたい箇所をかなに置き換える
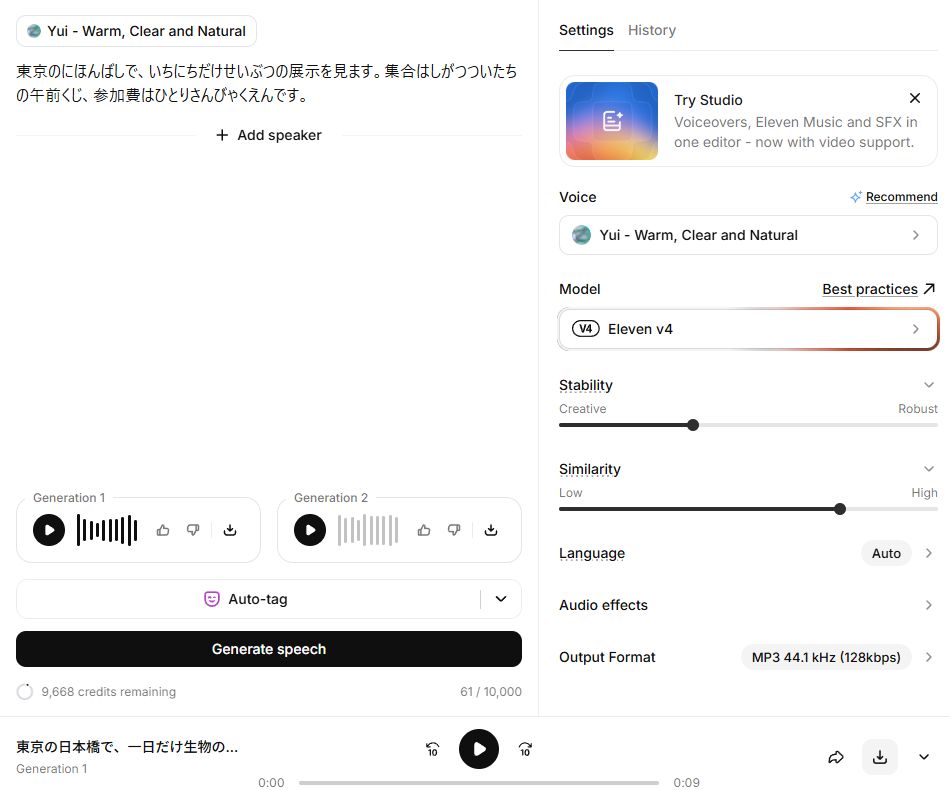
次は、同じ原稿の意味を保って、比較対象の語をかなに置き換えました。実際の修正では、聞いて問題があった語だけを直すのが基本です。今回は期間・日付・固有名詞をまとめて確認できる教材として、複数の語を明示しています。
東京のにほんばしで、いちにちだけせいぶつの展示を見ます。集合はしがつついたちの午前くじ、参加費はひとりさんびゃくえんです。
かなへの置換で入力は61文字になりました。声、モデル、Stability、Similarity、Language、出力形式はそのままです。Auto-tagも使っていません。声を変えたり感情タグを追加したりすると、読み方以外の差も増え、どの変更が効いたか判断しにくくなるためです。
括弧で『日本橋(にほんばし)』と追記する方法は、括弧内まで読んでしまう可能性があります。単純な読み上げでは、表示用の原稿と音声用の原稿を分け、音声用の語を置換するほうが比較しやすくなります。字幕は元の漢字表記を使えば、画面上の読みやすさも保てます。
比較結果の扱い:生成できたことと、読みが直ったことを分ける
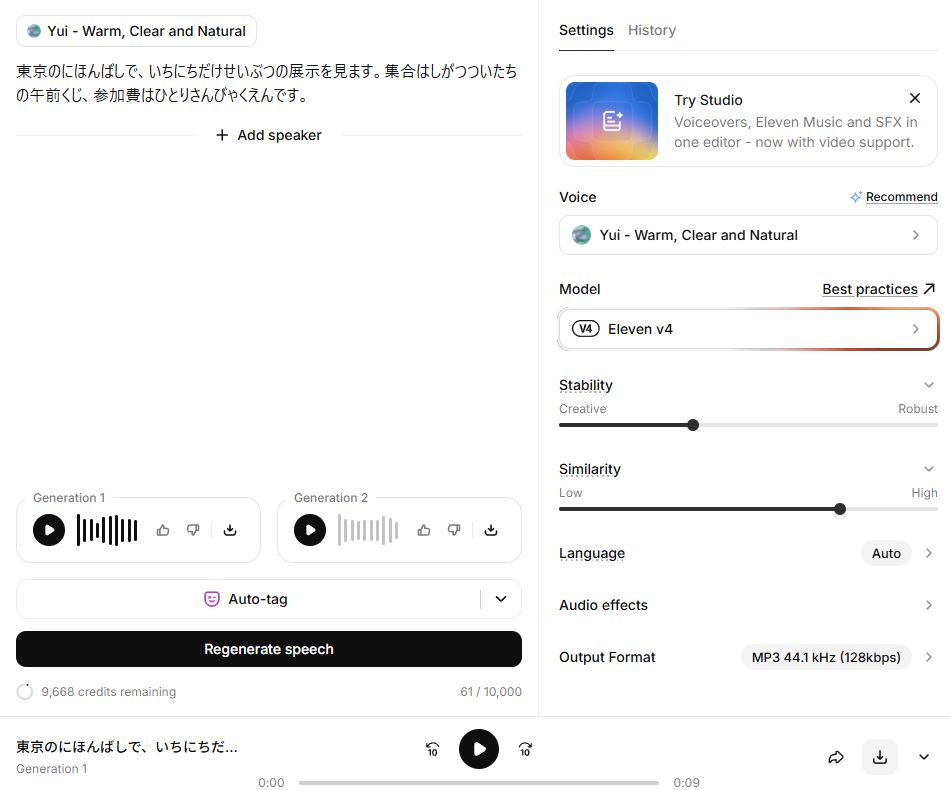
今回確認できたのは、二つの原稿について生成候補が作成され、Generation 1のMP3を保存できたことです。生成後の履歴には、漢字版とかな版がそれぞれ残りました。聴取で確認していないため、『日本橋を誤読した』『かなにして直った』『こちらのほうが自然』という評価は付けていません。
自分で聞き比べる場合は、まず『にほんばし』『いちにち』『せいぶつ』『しがつついたち』が目標どおりかを確認し、次に文全体のつながりを聞きます。かな版が正しく読めても、語の間が不自然なら、対象の語を一つずつ戻して必要な置換を絞ります。正しい読みと自然な説明の両方を満たして初めて採用です。
別の生成候補へ切り替える場合は、台本の修正とは分けて記録してください。同じ設定でも候補の違いは出ます。一組だけの比較から、Eleven v4全体の日本語精度や、すべての声での効果を判断することはできません。
何度も出る語はStudioの発音辞書を検討する
短い一本なら音声用原稿の置換で進められますが、同じブランド名が章をまたいで何度も出る場合は、修正漏れが増えます。公式のStudio発音エディターは、単語の読みを置換するエイリアスや、対応するモデル向けの音素ルールを辞書に保存し、プロジェクトへ接続する仕組みです。
公式ヘルプで案内されている流れは、対象の単語を選ぶ、発音エディターを開く、置換内容を入力する、既存または新しい辞書へルールを追加する、プロジェクトへ接続した状態でプレビューする、というものです。エディターの出力には再生ボタンがあり、登録後の聞こえ方を確認できます。公式:Studio発音エディターの使い方
今回実操作したのはText to Speechの原稿置換です。Studioの辞書登録や、辞書がEleven v4の日本語に適用されたことは実証していません。また、公式の同ヘルプは音素タグについてEleven Flash v2とのみ互換性があると記載しています。日本語の読み間違いに対して、任意のモデルへIPAやSSMLの音素タグを貼れば直る、と案内することはできません。
辞書に登録するときも、同じ漢字が別の意味で出る場面に注意します。期間の『一日』と日付の『一日』を一律に同じかなへ置換すると、片方が意図と違う読みになる可能性があります。語だけで判断できない場合は、その文の音声用台本を直す方法を選びます。
今回の消費は108クレジット。全文の作り直しを減らす
実画面で確認した残クレジットは、開始前9,715、漢字版の生成後9,668、かな版の生成後9,607でした。差分は47+61=108クレジットです。二つの入力に対して一回ずつ生成ボタンを押した、この試行の実測値です。すべてのモデル、再生成、辞書プレビューで同じ料金になると保証する数字ではありません。
読みのテストでは、長い動画の全文を繰り返し作るより、問題の語を含む前後一文を切り出すと、消費と確認時間を抑えられます。切り出しで読みが決まったら、前後の文章へ戻したときのつながりをもう一度確認します。短い単語だけで正しく読めても、文脈で変わる可能性があるためです。
台本を修正した日、対象の語、期待する読み、声とモデル、変更した内容、残クレジット、採用理由を残してください。『何回生成したか』だけより、次に同じ語が出たときに再利用しやすい記録になります。今回の入力例と空欄の評価表を、テキストで用意しました。
音声を公開する前に、生成時点の利用条件を確認する
今回の音声はFreeの試行として生成しました。公式ではFreeの出力に商用ライセンスは含まれず、商用目的には使えないと説明されています。後から有料へ変更しても、それ以前に無料で生成した音声を商用素材へ切り替えることはできません。広告、受託動画、収益目的の公開に使う完成音声は、対応する契約条件を確認して新たに生成してください。
無料の音声を非商用で共有する場合も、タイトルへ『elevenlabs.io』または『11.ai』を含める帰属表示が必要です。『教材』と書くだけで商用サイト上の音声が自動的に許可されるわけではないため、このページではFreeの実音声を公開素材として配布していません。スクリーンショットと自作台本で手順を説明し、試行音声は制作記録として保管しています。公式:生成コンテンツの公開・商用利用条件
本番では、読みだけでなく、文の抜け、数字の意味、語の重複、語尾、映像との長さを最後まで確認します。機械の文字起こしは補助にはなりますが、漢字に正規化された結果だけで『にほんばし』と『にっぽんばし』の違いを判定することはできません。実際の音声を聞き、期待する読みと照合してから採用を決めましょう。
確認条件と出典
2026年10月13日にText to Speechで自作の漢字47文字・かな61文字をYui / Eleven v4、Stability35%、Similarity75%、LanguageAutoで各一回生成。Generation1のMP3を保存、実画面4枚を撮影。消費108クレジットを残高差で確認。聴取による読みの正誤・修正効果、Studio辞書の実適用は未確認。Free音声は商用利用条件のため記事に公開リンクを設置しない。